糖鎖と糖鎖結合性タンパク質(GBPs)間の相互作用に着目した治療薬開発の可能性について

本記事は、スロバキア科学アカデミー化学研究所の研究者による「人における糖鎖の役割」に関するレビュー論文のご紹介です。
https://www.mdpi.com/1420-3049/30/13/2678

本論文では、糖鎖とセレクチン、ガレクチン、シグレックといった糖鎖結合性タンパク質(GBP)間相互作用を標的とした治療薬開発の可能性について以下のようにまとめています。糖鎖関連技術を社会実装する上でのポイントが簡潔にまとめられていると思います。

    1) 糖鎖-GBP相互作用の阻害剤、例えばUproleselan(グリコミメティクス)
    2) 糖鎖を標的とするモノクローナル抗体、例えばガングリオシドGD2を標的とするDinutuximab/Unituxin(国立がん研究所)およびNaxitamab/Danyelza(メモリアル・スローン・ケタリング癌センター)
    3) 病原菌および癌に対する糖鎖ベースのワクチン、例えばインフルエンザ菌b型に対する糖鎖ベースのワクチン(サノフィパスツール、ヒベリックス、メルク社製Pentacel)、そしてまた癌ワクチンとして、sTn抗原、ガングリオシドGM2、糖脂質グロボHおよびガングリオシドGM3を標的とするTheratope(バイオミラ)、GM2-KLH(メモリアル・スローン・ケタリング癌センター)、OPT-822(OBIファーマ)、およびRacotumomab(ハバナ分子免疫学センター)
    4) 免疫チェックポイント阻害剤(ICI)の効率化
    5) 糖転移酵素阻害剤(CPI)による糖鎖生合成の改変

ご参考になれば幸いです。

糖鎖関連ビジネスを成功させる為には何が必要なのか?

糖鎖は、核酸、タンパク質に次ぐ第三の生命鎖として注目されていることは周知の事実であります。

糖鎖の主な機能とは、(1)細胞認識、(2)細胞接着、(3)シグナル伝達、(4)タンパク質の機能調整、そして(5)免疫応答であると言われます。恐らくこれらの根幹にある機能は、自己と非自己の認識機能であると考えられます。糖鎖は細胞の顔と言われるように、細菌やエンベロープ型ウイルス、正常細胞と癌細胞、そしてまたES, iPSといった幹細胞らで大きく違っています。このような糖鎖の違いを認識する機能分子としてレクチンが存在しています。レクチンには、細胞膜上に発現するものと分泌型のそれがあります。細胞膜上に発現するレクチンの代表例は、C-型レクチンやSiglecであり、分泌型レクチンの代表例には、血中に存在するMBLやフィコリンがあります。C-型レクチンとしては、DC-SIGN, Langerin, Dectin-1, MGLなど数多くの種類が知られていて、その基本的な機能は、外来異物の糖鎖を認識し、自然免疫反応を誘起することであります。Siglecの場合は、発現する細胞はほとんどが免疫細胞であり、シアル酸を認識して免疫作用の調製に関与します(癌治療において、SiglecがPD-1同様に免疫チェックポイント分子になっていることが良く知られています)。MBL(これもC-型レクチンですが)らの分泌型レクチンは、血中を流れる外来異物の糖鎖を認識し、補体経路を活性化して自然免疫反応を誘起しています。

細胞接着という観点での代表例は、炎症が起こった時に血管内皮に発現するP-セレクチンと白血球上のシアロ糖鎖との相互作用、癌の転移能に糖鎖が関わっていること、更にはウイルスの感染と言った事例を上げることができます。最も代表的な例がインフルエンザウイルスの感染であり、ウイルスの持つヘマグルチニンと宿主細胞のシアル酸が結合することで、ウイルスエンベロープと宿主細胞間の細胞膜融合が誘起されます。SARS-CoV2の場合には、ウイルスのRBDと宿主細胞のACE-2が結合することが細胞膜融合を誘起するとされていますが、宿主細胞のC-型レクチンにSARS-CoV2の糖鎖が結合することで感染が誘起されるという経路も知られています。

シグナル伝達とタンパク質の機能調整ですが、殆どすべての膜たんぱく質には糖鎖修飾が存在することから、受容体とリガンドの結合に糖鎖が関係してしまうのはしごく当たり前な話であります。糖鎖が受容体とリガンドの結合に抑制的に働く場合もあれば、増強的に働く場合もあります。抑制的に働くのは糖鎖による結合阻害だとして容易に理解ができると思います。抑制的に働く例としては、IgGのFc部がコアフコース化されるとIgGとFcR間の相互作用が抑制されてADCC活性が下がる事例が有名です。増強的に働く例としては、免疫チェックポイント分子であるPD-1がコアフコース修飾されるとPD-1の発現が上昇しPD-L1との結合が強くなるというような事例を上げることができます。レクチンの中でもガレクチンは変り者で、細胞質、細胞膜、細胞外に存在します。分泌型のガレクチンは何をしているのでしょうか?一つの例は、FGFRに発現しているガラクシドに結合し、FGFが正規なリガンドであるとすれば、それをミミックするような機能を持っていたりもします。

このようにして糖鎖とレクチンの機能を概観してみると、攻めどころは下記になると考えられます。
1.診断薬応用
糖鎖は発現系であり、細胞の状態の違いを如実に反映しています。従って、新たな疾患バイオマーカーとなり得る可能性は非常に高くなります。しかしながら、糖鎖は非常にヘテロな集団ですし、似たような糖鎖構造がターゲット細胞以外でも発現している場合があるので、特異性が問題になります。対象疾患から分泌される特異的なタンパク質とその疾患に特異的な糖鎖を同時に測定することが特異性の改善につながります。更には、糖鎖は増幅することが困難であることから、感度も大問題になってきます。この二面性を包括的に解決できるような対象疾患を慎重に選択する必要があります。成功している検査薬には、AFP-L3やM2BPGiがありますが、両方とも肝臓疾患であり、さもありなんと思わせます。

2.医薬品応用
細胞内のシグナル伝達は、リガンドと受容体の相互作用が起点となって誘起されます。リガンドを糖鎖という言葉で置き換えた時の受容体はレクチンという事になります。従って、糖鎖とレクチンという関係性を持って誘導されるシグナル伝達は、レクチンが備えている機能に限定されてしまいます。つまり、大部分が自然免疫がらみの機能になるかと思います。それでも見込める効果が十分であれば、ここを突き詰めるだけで大成功する可能性があります。インフルエンザウイルスの特効薬であるタミフルはこの良い例です。但し、タミフルは,ウイルスが宿主細胞から別の細胞へと感染を広げる際に必要となるノイラミニダーゼを阻害することが作用機序なので、宿主細胞のシアロ糖鎖を暴漢から守ってるイメージです。ともあれ、この路線では、レクチンが認識しないような糖鎖構造の詳細解析を推し進めても効果が薄いことが想像されます。
生体内には、その他無数のリガンドと受容体の相互関係が存在します。例えば、上記したようなIgGとFcR、FGFとFGFR、PD-1とPD-L1といった関係性です。これらの関係性においては、誘起される細胞内シグナル伝達においては、糖鎖が直接的に関与するわけではなく、そのリガンドと受容体間の相互作用に調整役として間接的に働くということになります。例えば、IgGを脱フコースした抗体医薬品の技術はポテリジェント技術として極めて有名です。糖鎖を標的とする創薬というと、糖鎖がありとあらゆるところに存在するが故に、糖鎖が様々な生命現象に関与しているとして大風呂敷になりがちです。本ブログ管理人が考えるに、効率的に開発するためには、新規モダリティーにこだわるよりも、むしろ既存の医薬品に対して糖鎖修飾の違いがどのように影響を与えるのかをシアリダーゼらを駆使してスクリーニングした方が効果的であり、それによってより薬効の高い新薬(バイオベター)を発見できる可能性が高いのではないでしょうか。この視点では、最終的に糖転移酵素の制御がキーになる可能性もありますよね。

前立腺がん治療の分子標的候補にFUT-8が浮上

Newcastle University Centre for Cancer, Newcastle University Institute of Biosciences, Newcastle, UKらのグループは、FUT-8 は前立腺がんの治療における分子標的となる可能性があると報告しています。
https://pmc.ncbi.nlm.nih.gov/articles/PMC12086987/

本研究においては、FUT8は前立腺癌の進行の重要な因子であることが示されており、前立腺腫瘍におけるコアフコシル化のさらなる特徴解明の必要性が示唆されています。
前立腺がんの生物学的なFUT8の重要な役割を考えると、FUT-8が前立腺がん治療の分子標的となる可能性があると結論されています。

複数個のレクチンを使用して得られたLPSの糖鎖プロファイルに機械学習を適用して細菌種を同定するセンサー

Department of Chemistry, Pavillon Alexandre-Vachon, 1045, avenue de la Médecine, Université Laval, Quebec, Canadaのグループは、複数個のレクチンを用いたLipopolysaccharide (LPS)の糖鎖プロファイルとそれに機械学習と組み合わせた細菌種の検出法について報告しています。
https://pmc.ncbi.nlm.nih.gov/articles/PMC12019741/

グラム陰性細菌の主要構成成分であるLPSの検出と分類は、医療、環境モニタリング、食品安全といった分野において根幹を成す重要な課題です。

本研究では、表面プラズモン共鳴(SPR)センサー上に固定化された2種類から7種類のレクチンパネルを用いた新たなアプローチが示されています。細菌固有の糖鎖結合プロファイルに基づき、機械学習手法と組み合わせることで、細菌種を高精度に同定できています。使用した機械学習手法は、ランダムフォレスト(RF)、k近傍法(kNN)、サポートベクターマシン(SVM)です。

このようなマルチプローブと機械学習手法を組み合わせた検出手法は、センサー構築における最近のトレンドと言えるでしょう。

レクチンの応用は医療だけなのか?いや農業分野にも可能性はある!

Instituto de Química, Departamento de Química de Biomacromoléculas, Universidad Nacional Autónoma de México らのグループは、二枚貝から抽出される新しいレクチンのファミリー、mytilectin、について、その糖鎖結合特性と応用について報告しています。
https://www.sciencedirect.com/science/article/pii/S0141813025028909?via%3Dihub

レクチンは、医療的な視点から、腫瘍細胞を標的とするプローブ分子や治療薬として評価されてきました。本論文では、医療応用ではない他分野、即ち農業分野における植物病原菌に対する生物防除剤としてレクチンを使用することを提案しています。

本論文では、作物の収穫に大きな影響を与える2種類の真菌と2種類の卵菌に対するmytilectinの抗真菌および抗卵菌活性が示されています。Mytilectinは、真菌の Alternaria alternata と Fusarium oxysporum、および卵菌の Phytophthora capsici と Pythium aphanidermatum の成長を完全に阻害しました。特に、mytilectinが市販の抗真菌制御剤 (CAPTAN) よりも優れた阻害特性を示すことは注目に値します。

ヒト・レクチンを搭載するレクチンアレイの登場

Department of Life Sciences, Imperial College, London SW7 2AZ, United Kingdom のグループは、ヒト・レクチンを用いたレクチンアレイに関する論文を発表しました。
ヒト・レクチンを搭載するレクチンアレイ

本論文は、2023年8月27日~9月1日に台北で開催されたGlyco 26において口頭発表された研究が論文化されたものです。
39種類のヒト・レクチンがスライドグラス上に固定化されています。

現存するレクチンアレイ(LecChipなど)は、主に植物レクチンを使用しています。このタイプのレクチンアレイは、比較糖鎖プロファイリング解析を行う上にいては、十分強力です。しかしながら、ヒトと病原体との相互作用を解析するには、このタイプのレクチンアレイよりも、ヒト・レクチンアレイを用いた方がベターかも知れませんね。

LecChip(レクチンマイクロアレイ)のデータを用いてDeep Learningで糖鎖の構造や細胞種などを機械学習を行わせる時の環境構築とPython Script例

LecChip(レクチンマイクロアレイ)のデータを使用して、糖鎖の構造、細胞種などを判別させるためには、Deep Learningを使用して沢山のデータを機械学習させる方法が有効です。
これを行う為に必要な事前準備は、以下となります。
Python(以下ではAnaconda3を使用)
Tensorflow
Keras
先ずは、ご自身のパソコンにこれらをインストールして環境構築を行ってください。

このような事前準備の面倒臭さを省き、Deep Learningのネットワーク構成をマウスでのクリック動作だけで出来るようにしたのが弊社製品の「SA/DL Easy」になります。
SA/DL Easyを使うと、環境構築の必要もなく、以下のようなScriptも書かずに、Deep Learningの世界がたやすく使えるようになります。

下記を自身のパソコンで実行される場合には、PythonのScriptを保存したフォルダー内にpathが通っていること、保存した入力データのpath、学習結果とテスト結果が保存されているフォルダーのpathなどを間違えないように指定してください。

———————————————————————————————
# LecChipのデータを使って、例えば、糖鎖の構造や細胞種の判断を学習させるためのDeep Learning Python Script例

from __future__ import print_function
import numpy as np
import csv
import pandas
from keras.datasets import mnist
from keras.models import Sequential
from keras.layers.core import Dense, Dropout, Activation
from keras.optimizers import RMSprop
from keras.utils import np_utils
from make_tensorboard import make_tensorboard

np.random.seed(1671) # 再現性を良くするために

# ニューラルネットワークの構成と学習のさせ方
NB_EPOCH = 100 # 何回学習させるか、適当に決めてください
BATCH_SIZE = 2  # データセットを幾つかのサブセットに分ける
VERBOSE = 1
NB_CLASSES = 2 # 最終的な出力数
OPTIMIZER = RMSprop() # オプティマイザー
N_HIDDEN = 45  # 隠れ層のノード数、ここではLecChipのレクチン数に合わせて45としている
VALIDATION_SPLIT = 0.2 # 学習データの内、何割をテストデータとして使うか
DROPOUT = 0.3
LECTINS = 45

def drop(df):
return df[pandas.to_numeric(df.iloc[:, 2], errors=’coerce’).notnull()]

# データは最大値を1とするように規格化する
def normalize_column(d):
dmax = np.max(d)
dmin = np.min(d)
return (np.log10(d + 1.0) – np.log10(dmin + 1.0)) / \
(np.log10(dmax + 1.0) – np.log10(dmin + 1.0))

def normalize(data):
return np.apply_along_axis(normalize_column, 0, data)

# 入力するデータはCSVファイルの形式とする
df1 = drop(pandas.read_csv(r’c:\Users\Masao\Anaconda3\DL_scripts\cell.csv’)).reset_index(drop=True)
X_train = normalize(df1.iloc[:, 2:].astype(np.float64))
family_column = df1.iloc[:, 1]
family_list = sorted(list(set(family_column)))
Y_train = np.array([family_list.index(f) for f in family_column])

df2 = drop(pandas.read_csv(r’c:\Users\Masao\Anaconda3\DL_scripts\cell_test.csv’)).reset_index(drop=True)
X_test = normalize(df2.iloc[:, 2:].astype(np.float64))
familyt_column = df2.iloc[:, 1]
familyt_list = sorted(list(set(familyt_column)))
Y_test = np.array([familyt_list.index(f) for f in familyt_column])

print(X_train.shape[0], ‘train samples’)
print(X_test.shape[0], ‘test samples’)

# convert class vectors to binary class matrices
Y_train = np_utils.to_categorical(Y_train, NB_CLASSES)
Y_test = np_utils.to_categorical(Y_test, NB_CLASSES)

print(X_train)
print(Y_train)
print(X_test)
print(Y_test)

# ニューラルネットワークの具体的な構成例
# 隠れ層は2層
# 入力はLecChipのデータ(45レクチンを使用)
# 最終層はsoftmaxで活性化

model = Sequential()
model.add(Dense(N_HIDDEN, input_shape=(LECTINS,)))
model.add(Activation(‘relu’))
model.add(Dropout(DROPOUT))
model.add(Dense(N_HIDDEN))
model.add(Activation(‘relu’))
model.add(Dropout(DROPOUT))
model.add(Dense(NB_CLASSES))
model.add(Activation(‘softmax’))
model.summary()

# 学習とテスト結果状況をTensorboardに出力して可視化させる
callbacks = [make_tensorboard(set_dir_name=’Glycan_Profile’)]

model.compile(loss=’categorical_crossentropy’,
optimizer=OPTIMIZER,
metrics=[‘accuracy’])

model.fit(X_train, Y_train,
batch_size=BATCH_SIZE, epochs=NB_EPOCH,
callbacks=callbacks,
verbose=VERBOSE, validation_split=VALIDATION_SPLIT)

score = model.evaluate(X_test, Y_test, verbose=VERBOSE)
print(“\nTest score:”, score[0])
print(‘Test accuracy:’, score[1])

————————————————————————————
# Tensorboardを使うためのPython Script

# -*- coding: utf-8 -*-
from __future__ import absolute_import
from __future__ import unicode_literals
from time import gmtime, strftime
from keras.callbacks import TensorBoard
import os

def make_tensorboard(set_dir_name=”):
ymdt = strftime(“%a_%d_%b_%Y_%H_%M_%S”, gmtime())
directory_name = ymdt
log_dir = set_dir_name + ‘_’ + directory_name
os.mkdir(log_dir)
tensorboard = TensorBoard(log_dir=log_dir, write_graph=True, )
return tensorboard

————————————————————————————
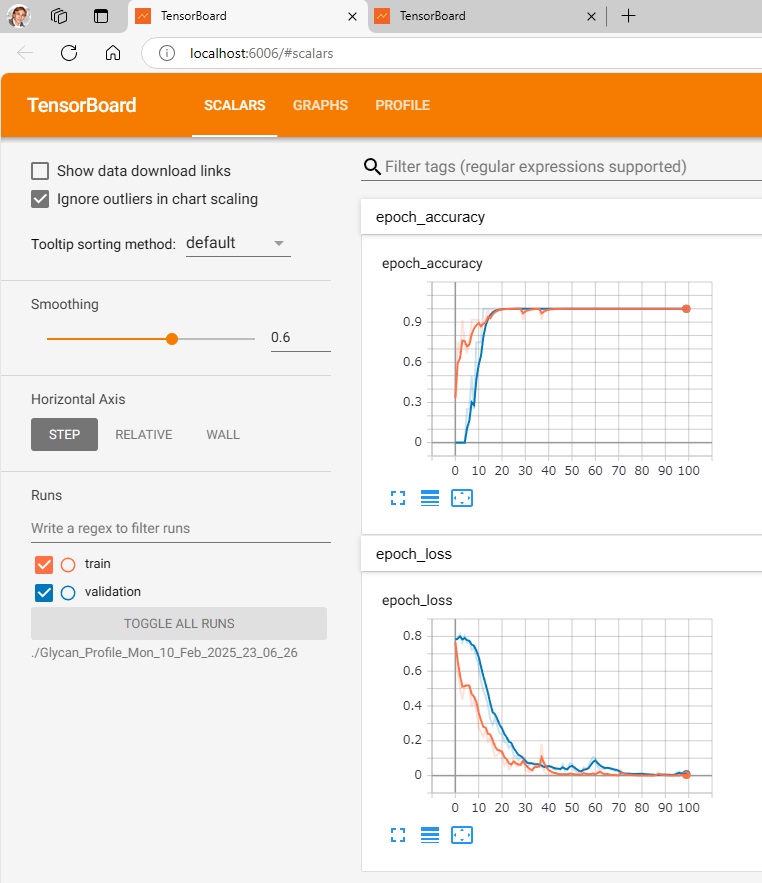
Tensorboardを用いて可視化させるには、make_tensorboard.pyを走らせたうえで、
$ tensorboard –logdir=./Glycan_Profile_Mon_10_Feb_2025_23_06_26(./データが記録されているフォルダー)を走らせ
http://localhost:6006/にアクセスします。

(base) PS C:\Users\masao\Anaconda3\DL_Scripts> python make_tensorboard.py
Using TensorFlow backend.
(base) PS C:\Users\masao\Anaconda3\DL_Scripts> tensorboard –logdir=./Glycan_Profile_Mon_10_Feb_2025_23_06_26
Serving TensorBoard on localhost; to expose to the network, use a proxy or pass –bind_all
TensorBoard 2.0.2 at http://localhost:6006/ (Press CTRL+C to quit)
—————————————————————————————————-
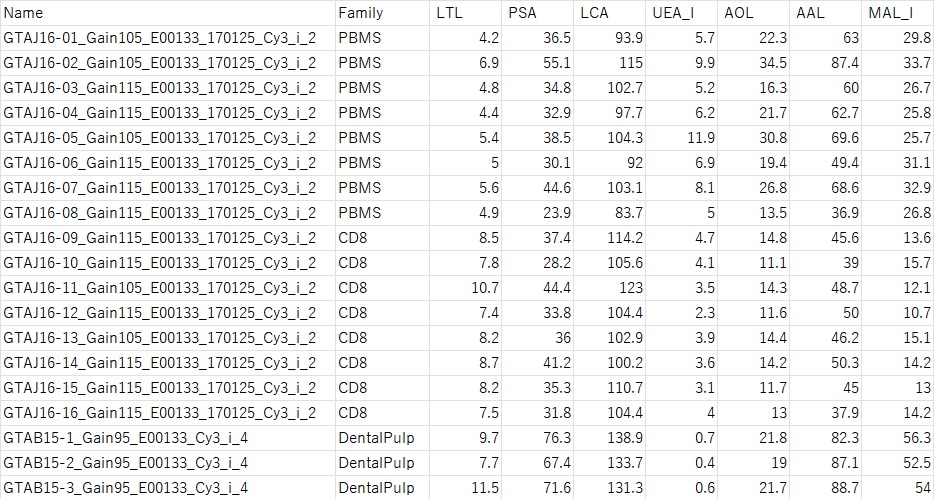
LecChipのデータは、下記のようなCSV形式とします。
左端から、サンプル名、ファミリー名(教師データとなります)、各種レクチンの数値が並んでいます。
—————————————————————————————————-
学習が終わったら、モデルの保存をしておくべきでしょう。
モデルが保存してあれば復元もできますし、未知データを与えて予測させることが出来ます。
この辺りのScriptは別途書くことにします。

AIの進化ビジョン

OpenAIのサム・アルトマンが東京大学で「AIの進化ビジョン」について講演をしたという。
その中で述べていることを引用すると、次のようである。
「ある学生が「今後10年、30年、100年後の社会はどのように変化すると思いますか?」と問いかけると、アルトマンは「10年後にはAIが科学技術の進歩を加速させ、30年後には社会のあらゆる側面がAIと一体になって、ともに進化しているだろう」と即答した。100年後の未来については「現時点では想像もつかないが、人間の生活は今とはまったく異なるものになるだろう」とアルトマン氏は答える。」

AIの進歩が人類の生活に好影響を与えるのは確かだろう。しかし、それはAIがあくまでも人間のツールである段階にとどまるのではないだろうか?人が面倒くさいと思うことや、手間がかかることを他の人に代行を頼む状況とよく似ている。ここでいう他の人がAIに変わっただけのことである。面倒なことや手間がかかることを代行してもらうことで、自身はより生産性の高い仕事に専念できるようになる。AIの推論機能が高まってくれば、人が思いもしなかったような解決法が発見されるかもしれないし、それによって科学技術も加速進歩するだろう。

問題は100年後である。AIの能力が人を超えてしまうと、一般人が太刀打ちできないような天才に出会った時と同じように、恐らく知的に戦う気力を失ってしまうだろう。自分が考えたって勝てっこない、そういう劣等感が人のやる気を奪い、単にAIに生かされる動物にヒトがなってしまう可能性が多分にある。
人はその時代には生産活動から解放され、かつては収入の源泉であった知的活動も、戦っても勝てもしないAIを眼前にしてその対価さえ無価値に等しくなり、遊びふけるだけの存在になってしまっているのではないだろうか?

この時にぶつかるこの問題を克服するには、人も同様に進化してAIと同等以上の能力を獲得するしか方法がない。AIと脳が合体する時代の到来である。その時に、この生き物が人と呼べるのか?それすら確かではない。

ALAレクチンが胆管癌の治療に有効かもしれない

Department of Biochemistry, Faculty of Medicine, Khon Kaen University, Thailandらのグループは、モンキーフルーツの種から抽出された新規レクチンALAについて報告しています。
https://www.nature.com/articles/s41598-024-84444-7

ALAは凝集素活性を示し、T- および Tn-抗原および単糖類 (Gal や GalNAc など) に対して糖鎖結合特異性を示しました。

ALAによって認識される糖鎖がヒト胆管癌 (CCA) 組織で増加していることが確認されました。ALAは、CCA 細胞、KKU-100 および KKU-213B、の細胞生存率をドーズ依存的に大幅に低下させ(最大 30 μg/mL まで)、最高濃度では約 30% の低下が観察されました。また、ALAは、細胞生存率には影響を与えない1 ~ 2 μg/mL の濃度でドーズ依存的に KKU-100 および KKU-213B 細胞の遊走および浸潤能力を大幅に低下させました。

これらの結果は、CCA治療に対するこのレクチンの潜在的な治療効果を示唆しているようです。

乾癬性関節炎(PsA)と関節リウマチ(RA)を区別できる新規糖鎖マーカー

Division of Laboratory Diagnostics, Department of Laboratory Diagnostics, Faculty of Pharmacy, Wroclaw Medical University, Polandらのグループは、乾癬性関節炎(PsA)と関節リウマチ(RA)を区別するための新規糖鎖マーカー、即ち血清クラステリンの糖鎖修飾変化、について報告しています。
https://www.mdpi.com/1422-0067/25/23/13060

PsA および RA は結合組織自己免疫疾患です。
本研究は、血清クラステリン (CLU) 濃度とその糖鎖修飾パターンがこれらの疾患を区別できるマーカーである可能性があるかどうかについて研究しています。

結果、以下の事柄が判明しました。
RA患者の血清中のCLU濃度は、PsA群と比較して有意に低く、CLU濃度に関しては、検査した群間にその他の有意差はありませんでした。

CLUに発現する糖鎖と SNA (α2-6 Sia 結合レクチン) の相対反応性は、対照群と比較して、RAおよびPsA患者で有意に高く、CLUに発現する糖鎖とMAA (α2-3 Sia 結合レクチン) の相対反応性においては、研究グループ間に有意差はありませんでした。

これらの結果は、CLU濃度とシアル酸修飾(by SNA)によってPsAとRAが区別できることを示しています。

Powered by WordPress |Copyright © 2020 Emukk. All rights reserved