アーカイブ: 2025年2月13日

GlycoStation誕生秘話(1)

GlycoStationとは、レクチンマイクロアレイとエバネッセント波蛍光励起法を用いたスキャナーを組み合わせて比較糖鎖プロファイリング解析を行う糖鎖解析のプラットフォーム技術の登録商標であります。この名称自体は、本ブログ著者(山田雅雄)が、モリテックス・横浜テクニカルセンターのグライコミクス研究所に在籍していた時代に名付けられたものです。そして、レクチンマイクロアレイにはLecChipという商標を獲得し、エバネッセント波蛍光励起法を用いたスキャナーには、GlycoStation Reader 1200(略して、GSR1200)という商品名が付けられました。また、GSR1200については、糖鎖の比較構造解析を非破壊で高精度に行えるという特徴を強調すべく、「糖鎖プロファイラー」という技術名称が冠されました。この技術は、バイオテクノロジーの中では数少ない国産技術として一世を風靡し、GSRは延べ40台以上が製造販売され、日本だけでなく、米国、欧州、東アジアにおいて広く使用されているのです。

この「GlycoStationの誕生秘話」をMxブログ記事として記録しておこうと思い立ちました。

その第一話は、2002年にまで遡り、当時名古屋にあったベンチャー企業である日本レーザー電子(NLE)から話はスタートします。日本レーザー電子は、最盛期には、30名を超える従業員が在籍し、売上高も5億円を超える事業規模を持っていましたが、残念なことに、起業してから約20年後の2004年に経営破綻を迎えてしまいました。日本レーザー電子の社長であった米田勝實氏は、元名城大学理工学部電気工学科の助教授であり、レーザー計測技術を専門としていました。彼が大学を退職し、日本レーザー電子を起業した時の事業内容は、もちろんレーザー計測技術の社会実装です。会社の成長と共に事業分野が拡大され、ナノテク関連製品を加え、更にはバイオテクノロジー関連にも事業分野を広げて行きました。ナノテク関連商品として最も有名なものはオスミュウム(Os)・コーターでしょう。これは電子顕微鏡用のサンプルを真空中でOsを薄くコーティングすることにより、サンプルのチャージアップを防ぎ、高精度に高倍率の電子顕微鏡画像が得られるようにするサンプル前処理装置です。またLB膜(ラングミュア-ブロシェット膜)製造装置も研究開発分野で評判を得ていました。LB膜はご存知のように水面上に展開した単分子膜を基板上に移しとって積層した分子膜であり、当時は半導体にしても超格子構造がいくつか実用化されており、機能分子を積層することで新しい分子デバイスを作り上げようという機運が高かった時期でもありました。そうそう、UVオゾンクリーナーもありました。DNAマイクロアレイの分野では、半導体の製造技術を真似たAffymetrixのGeneChipが2000年当時、すでに世界で圧倒的な強さを発揮していました。DNAマイクロアレイの事業分野の急速な拡大を目にして、日本レーザー電子は日本でいち早くDNAマイクロアレイ事業に参入し、2002年には、すでに5400種類を超えるマウスのcDNAをスポッティングしたDNAマイクロアレイを実用化していました。DNAマイクロアレイの製造には独自の先割れピンを用いたスポッターを自社開発し、大型のStampIIやラボ向けのStampmanというスポッターも自社開発し、マイクロアレイを読み取るためのレーザースキャン型の共焦点スキャナー(Scan II)らも商品に加えていました。バイオテクノロジー分野では、SPR分野にも積極的に進出し、国内ではBiacoreに続く二位のマーケットシェアを獲得していました。

自分が日本レーザー電子に参画したのは、2002年夏のことです。当時の日本レーザー電子は、本社を熱田区に置いていました。本社の入り口を入ると、右側に営業部(営業部長は、奥村秀行氏)があり、左手の鉄製の階段を上って右上(駐車場の上なのだが)に社長室が、左側には会議室や経理部がありました。入り口からの通路は奥深くまで長く長く伸びており、右側にはバイオテック用のクリーンルームやスキャナー開発用の暗室、最深部には理化学機器製造の部屋があり、その二階が技術開発部の居室となっていました。日本レーザー電子には、自分は開発部長として着任しました。前職(富士通株式会社)に比べると環境が全く異なりますし、現場を率いてきた社員たちの個性や能力をつかみ、この部隊をどうまとめ上げていくのがベストかを直感できるようになるまでには少々時間がかかりました。自分は富士通の部長をしていたので、皆さんもそれなりに敬意を払っては下さるのですが、何せよそ者ですし、違和感満載でした(笑)。バイオテクノロジー関連では、中国の医師免許を持つドクター(島田亮氏)や京大農学部卒のドクターもおり、機器開発には優れたノウハウを有する技術者も数名在籍しており、名大工学部卒のドクター(高島成剛氏)もいました。総じて高い技術力を持つ集団であり、正真正銘、新規開拓に挑戦的に挑むベンチャーという印象です。

入社ほどなくして、自分は取締役に昇進し、毎月の経営会議に顔を出す立場となりました。それから1年後には副社長になっていました。転職前に米田社長から聞いていた話とは裏腹に、経営状態は悲惨でした。経営会議は会議というのは名ばかりで正に喧嘩状態、「生きるか死ぬか」という瞬間が今ここにあることを実感します。
「これ売れなかったら、来月給料ないよ」机をたたく音と怒号が響き渡る会議です。
入社してから知ったのですが、日本レーザー電子は自分が入社した時点ですでに債務超過に陥っていたのです。
経理部長からは、
「山田さん、入社前に米田社長から聞いてなかったの?」と言われて返す言葉もありません。
社長から名古屋の料亭でヘッドハンティングを受けて、美しい言葉だけを聞かされて、疑わなかった自分が甘かったのだ、そう思いました。しかし、当時の富士通の半導体事業も迷路に入ってしまっていましたから、どの道、自分は新天地を求めようとしていたのです。

日々の仕事は、取締役兼開発部長として、米田社長のご子息(米田英克氏)と協力して、cDNAマイクロアレイ、多チャンネル型のSPR装置(12ch-SPR)、エバネッセント波蛍光励起型スキャナー(SCAN III)らの開発をリードしつつ、経営者として、最後は副社長として、会社の立て直しのための事業プラン作成と資金調達に奔走していました。新たな事業計画を作ってのVCや銀行からの資金調達、大手企業との事業提携、更には事業売却を組み合わせた生き残り戦略の実践です。米田社長と二人で東京、関西、名古屋を飛び回る日々が続きました。いろいろ差し障りがありそうなので、何処とどういう交渉を行ってきたのかは流石にここではカットしておきたいと思います。とにかく債務超過という現実は、非常に厳しいです。
「すごい、面白い技術ですね、マジ凄いです」
「しかし、この負債の大きさは厳しいですね」
「少し考えさせてください」・・・・・・、そしてすべての交渉がぶっ飛んで行きました。

しかし、何故、日本レーザー電子が債務超過に陥ったのでしょうか?それには幾つかの原因があります。一つは、タンパク質アレイの失敗、cDNAマイクロアレイの伸び悩み、SPRのピークアウト、そしてJSTのA-STEPの失敗でしょう。言い換えれば、多額の開発費を掛けたにも関わらず売れる新製品が生まれず、既存の売上も低迷し、キャッシュアウトしていたということです。この中でも最大の失敗は、A-STEPの事業だろうと思います。とある大学と産学連携で開発してきた技術なのですが、完成した頃には、技術的に競合するAFMの台頭に優位性を完全に失い、AFM関連マーケットを完全に失ってしまったのです。それにも関わらず、ともあれ技術は完成したんだからと成功のレッテルを貼られ、2億円を超える開発費が借金として丸ごと日本レーザー電子に降りかかったのです。これがなければ債務超過にはならなかったのではと思います。

そんな中、2002年末に、自分にとって大きな転機が訪れました。なんと、日本レーザー電子に入社して半年も経っていません(笑)。ひとつは鹿児島大理学部の隅田先生との出会いであり、もうひとつは産総研の平林先生との出会い、そして最後のひとつはモリテックスとの出会いでありました。隅田先生とは糖鎖アレイ、平林先生とはレクチンアレイ、そしてモリテックスは事業買収につながる案件でした。
激動の2003年が過ぎ去り、万策尽きて2004年春にはNLEは倒産することになるのですが、日本レーザー電子は、結局二つのグループに分裂して事業継承を進めることになりました。米田社長と自分らは、モリテックスのバイオテクノロジー関連技術の事業買収に乗っかり名古屋から横浜に転居することとなり、英克氏らは株式会社竹代の支援を得てナノテクノロジー関連と受託サービス関連を継承して名古屋に残るのです。後者が現在の受託解析サービスを主力事業とするフィルジェン㈱です。そして、日本レーザー電子で埋もれていた「SCAN III」が、糖鎖とレクチンという新世界でモリテックスから新たな装いと仕様変更を受け、国産独自技術「GSR1200」として花を開かせることになるのです。

会社が倒産して皆が散り散りばらばらになる悲哀は、例えようがないくらい辛いです。社長が社員の親睦会のためにと取ってあった20万円で、会社の屋上に皆が集合して、あわびや伊勢海老といった極上食材を肴にバーベキューをして別れを惜しんだあの日の思い出、これは消え去ることはありません。社長は飲みすぎて転んで頭から血を流しました(笑)。富士通を退職しての自分の再出発は、僅か1年半で再出発を余儀なくされたのです。

この続きは「GlycoStation誕生秘話(2)」にて・・・・、
LecChip(レクチンマイクロアレイ)のデータを用いてDeep Learningで糖鎖の構造や細胞種などを機械学習を行わせる時の環境構築とPython Script例

LecChip(レクチンマイクロアレイ)のデータを使用して、糖鎖の構造、細胞種などを判別させるためには、Deep Learningを使用して沢山のデータを機械学習させる方法が有効です。
これを行う為に必要な事前準備は、以下となります。
Python(以下ではAnaconda3を使用)
Tensorflow
Keras
先ずは、ご自身のパソコンにこれらをインストールして環境構築を行ってください。

このような事前準備の面倒臭さを省き、Deep Learningのネットワーク構成をマウスでのクリック動作だけで出来るようにしたのが弊社製品の「SA/DL Easy」になります。
SA/DL Easyを使うと、環境構築の必要もなく、以下のようなScriptも書かずに、Deep Learningの世界がたやすく使えるようになります。

下記を自身のパソコンで実行される場合には、PythonのScriptを保存したフォルダー内にpathが通っていること、保存した入力データのpath、学習結果とテスト結果が保存されているフォルダーのpathなどを間違えないように指定してください。

———————————————————————————————
# LecChipのデータを使って、例えば、糖鎖の構造や細胞種の判断を学習させるためのDeep Learning Python Script例

from __future__ import print_function
import numpy as np
import csv
import pandas
from keras.datasets import mnist
from keras.models import Sequential
from keras.layers.core import Dense, Dropout, Activation
from keras.optimizers import RMSprop
from keras.utils import np_utils
from make_tensorboard import make_tensorboard

np.random.seed(1671) # 再現性を良くするために

# ニューラルネットワークの構成と学習のさせ方
NB_EPOCH = 100 # 何回学習させるか、適当に決めてください
BATCH_SIZE = 2  # データセットを幾つかのサブセットに分ける
VERBOSE = 1
NB_CLASSES = 2 # 最終的な出力数
OPTIMIZER = RMSprop() # オプティマイザー
N_HIDDEN = 45  # 隠れ層のノード数、ここではLecChipのレクチン数に合わせて45としている
VALIDATION_SPLIT = 0.2 # 学習データの内、何割をテストデータとして使うか
DROPOUT = 0.3
LECTINS = 45

def drop(df):
return df[pandas.to_numeric(df.iloc[:, 2], errors=’coerce’).notnull()]

# データは最大値を1とするように規格化する
def normalize_column(d):
dmax = np.max(d)
dmin = np.min(d)
return (np.log10(d + 1.0) – np.log10(dmin + 1.0)) / \
(np.log10(dmax + 1.0) – np.log10(dmin + 1.0))

def normalize(data):
return np.apply_along_axis(normalize_column, 0, data)

# 入力するデータはCSVファイルの形式とする
df1 = drop(pandas.read_csv(r’c:\Users\Masao\Anaconda3\DL_scripts\cell.csv’)).reset_index(drop=True)
X_train = normalize(df1.iloc[:, 2:].astype(np.float64))
family_column = df1.iloc[:, 1]
family_list = sorted(list(set(family_column)))
Y_train = np.array([family_list.index(f) for f in family_column])

df2 = drop(pandas.read_csv(r’c:\Users\Masao\Anaconda3\DL_scripts\cell_test.csv’)).reset_index(drop=True)
X_test = normalize(df2.iloc[:, 2:].astype(np.float64))
familyt_column = df2.iloc[:, 1]
familyt_list = sorted(list(set(familyt_column)))
Y_test = np.array([familyt_list.index(f) for f in familyt_column])

print(X_train.shape[0], ‘train samples’)
print(X_test.shape[0], ‘test samples’)

# convert class vectors to binary class matrices
Y_train = np_utils.to_categorical(Y_train, NB_CLASSES)
Y_test = np_utils.to_categorical(Y_test, NB_CLASSES)

print(X_train)
print(Y_train)
print(X_test)
print(Y_test)

# ニューラルネットワークの具体的な構成例
# 隠れ層は2層
# 入力はLecChipのデータ(45レクチンを使用)
# 最終層はsoftmaxで活性化

model = Sequential()
model.add(Dense(N_HIDDEN, input_shape=(LECTINS,)))
model.add(Activation(‘relu’))
model.add(Dropout(DROPOUT))
model.add(Dense(N_HIDDEN))
model.add(Activation(‘relu’))
model.add(Dropout(DROPOUT))
model.add(Dense(NB_CLASSES))
model.add(Activation(‘softmax’))
model.summary()

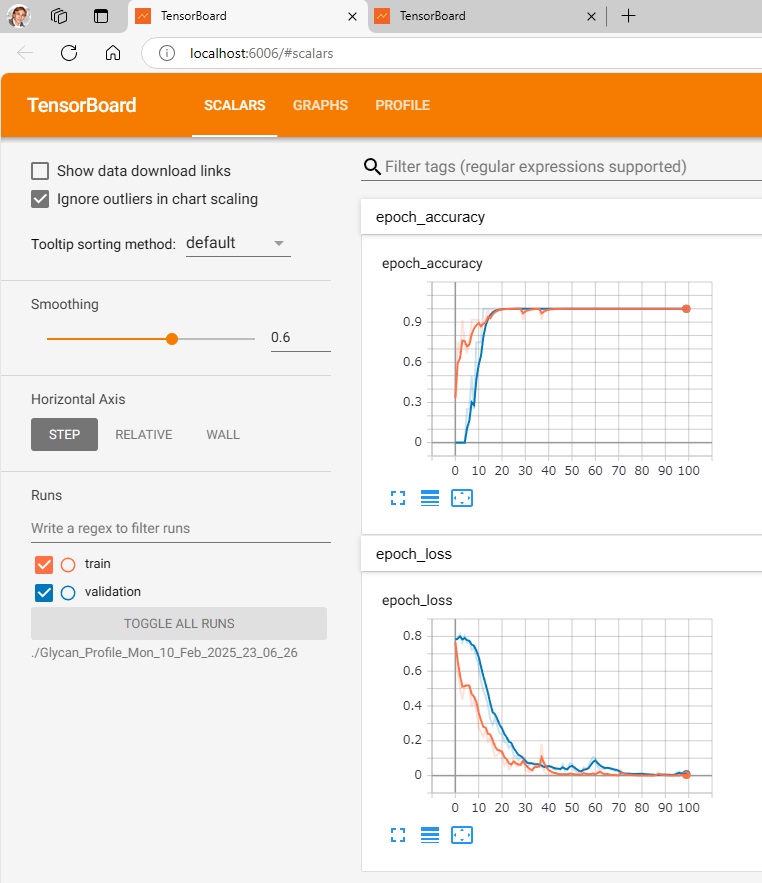
# 学習とテスト結果状況をTensorboardに出力して可視化させる
callbacks = [make_tensorboard(set_dir_name=’Glycan_Profile’)]

model.compile(loss=’categorical_crossentropy’,
optimizer=OPTIMIZER,
metrics=[‘accuracy’])

model.fit(X_train, Y_train,
batch_size=BATCH_SIZE, epochs=NB_EPOCH,
callbacks=callbacks,
verbose=VERBOSE, validation_split=VALIDATION_SPLIT)

score = model.evaluate(X_test, Y_test, verbose=VERBOSE)
print(“\nTest score:”, score[0])
print(‘Test accuracy:’, score[1])

————————————————————————————
# Tensorboardを使うためのPython Script

# -*- coding: utf-8 -*-
from __future__ import absolute_import
from __future__ import unicode_literals
from time import gmtime, strftime
from keras.callbacks import TensorBoard
import os

def make_tensorboard(set_dir_name=”):
ymdt = strftime(“%a_%d_%b_%Y_%H_%M_%S”, gmtime())
directory_name = ymdt
log_dir = set_dir_name + ‘_’ + directory_name
os.mkdir(log_dir)
tensorboard = TensorBoard(log_dir=log_dir, write_graph=True, )
return tensorboard

————————————————————————————
Tensorboardを用いて可視化させるには、make_tensorboard.pyを走らせたうえで、
$ tensorboard –logdir=./Glycan_Profile_Mon_10_Feb_2025_23_06_26(./データが記録されているフォルダー)を走らせ
http://localhost:6006/にアクセスします。

(base) PS C:\Users\masao\Anaconda3\DL_Scripts> python make_tensorboard.py
Using TensorFlow backend.
(base) PS C:\Users\masao\Anaconda3\DL_Scripts> tensorboard –logdir=./Glycan_Profile_Mon_10_Feb_2025_23_06_26
Serving TensorBoard on localhost; to expose to the network, use a proxy or pass –bind_all
TensorBoard 2.0.2 at http://localhost:6006/ (Press CTRL+C to quit)

—————————————————————————————————-
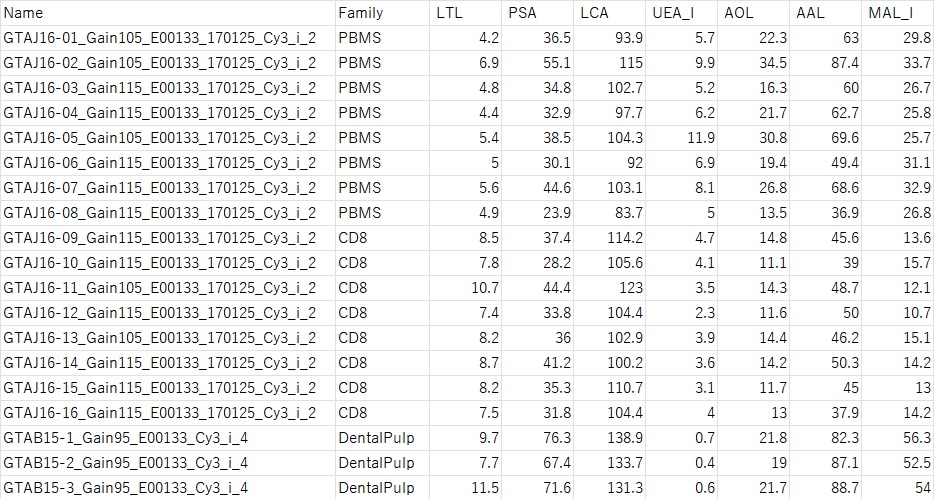
LecChipのデータは、下記のようなCSV形式とします。
左端から、サンプル名、ファミリー名(教師データとなります)、各種レクチンの数値が並んでいます。

—————————————————————————————————-
学習が終わったら、モデルの保存をしておくべきでしょう。
モデルが保存してあれば復元もできますし、未知データを与えて予測させることが出来ます。
この辺りのScriptは別途書くことにします。

AIの進化ビジョン

OpenAIのサム・アルトマンが東京大学で「AIの進化ビジョン」について講演をしたという。
その中で述べていることを引用すると、次のようである。
「ある学生が「今後10年、30年、100年後の社会はどのように変化すると思いますか?」と問いかけると、アルトマンは「10年後にはAIが科学技術の進歩を加速させ、30年後には社会のあらゆる側面がAIと一体になって、ともに進化しているだろう」と即答した。100年後の未来については「現時点では想像もつかないが、人間の生活は今とはまったく異なるものになるだろう」とアルトマン氏は答える。」

AIの進歩が人類の生活に好影響を与えるのは確かだろう。しかし、それはAIがあくまでも人間のツールである段階にとどまるのではないだろうか?人が面倒くさいと思うことや、手間がかかることを他の人に代行を頼む状況とよく似ている。ここでいう他の人がAIに変わっただけのことである。面倒なことや手間がかかることを代行してもらうことで、自身はより生産性の高い仕事に専念できるようになる。AIの推論機能が高まってくれば、人が思いもしなかったような解決法が発見されるかもしれないし、それによって科学技術も加速進歩するだろう。

問題は100年後である。AIの能力が人を超えてしまうと、一般人が太刀打ちできないような天才に出会った時と同じように、恐らく知的に戦う気力を失ってしまうだろう。自分が考えたって勝てっこない、そういう劣等感が人のやる気を奪い、単にAIに生かされる動物にヒトがなってしまう可能性が多分にある。
人はその時代には生産活動から解放され、かつては収入の源泉であった知的活動も、戦っても勝てもしないAIを眼前にしてその対価さえ無価値に等しくなり、遊びふけるだけの存在になってしまっているのではないだろうか?

この時にぶつかるこの問題を克服するには、人も同様に進化してAIと同等以上の能力を獲得するしか方法がない。AIと脳が合体する時代の到来である。その時に、この生き物が人と呼べるのか?それすら確かではない。

ガレクチンは単なるβ-ガラクシド結合型レクチンではなく多面的な機能を持っている

Axe of Infectious and Immune Diseases, CHU de Quebec-Université Laval Research Centre, Faculty of Medicine, and Research Centre for Infectious Diseases, Laval University, Quebec, Canadaらのグループは、宿主免疫におけるガレクチンの多面的な機能についてレビューしています。
https://www.sciencedirect.com/science/article/pii/S1044532324000642?via%3Dihub#bib63

他のレクチンとは異なり、ガレクチンはシグナルペプチドを欠いているため、糖鎖リガンドが存在しないサイトゾールで可溶性の非糖化タンパク質として合成されます。さらに、ガレクチン-1 やガレクチン-3 などの特定のガレクチンは、特定の条件下で核に移行することがわかっています。これは大きな矛盾です。何故ならば、ガレクチンの主な存在位置はサイトゾールであり、ガレクチンが結合する糖鎖が存在しない環境だからです。

しかし、興味深いことに、ガレクチンは、非古典的でリーダーのない分泌経路を介して細胞外空間に分泌されることもできます。

細胞内外のガレクチンのこの独特な分布は、ガレクチンの機能の多用性を示しており、宿主防御におけるガレクチンの機能がその合成とリガンドへのアクセスの空間的制御の両方によって調節されることを可能にする重層的な調節機構が存在することを示唆しており、ガレクチンの進化的役割は従来の糖鎖認識を超えて拡張されているようです。

非常に興味深いレビューとなっており、ご一読をお勧めします。

ALAレクチンが胆管癌の治療に有効かもしれない

Department of Biochemistry, Faculty of Medicine, Khon Kaen University, Thailandらのグループは、モンキーフルーツの種から抽出された新規レクチンALAについて報告しています。
https://www.nature.com/articles/s41598-024-84444-7

ALAは凝集素活性を示し、T- および Tn-抗原および単糖類 (Gal や GalNAc など) に対して糖鎖結合特異性を示しました。

ALAによって認識される糖鎖がヒト胆管癌 (CCA) 組織で増加していることが確認されました。ALAは、CCA 細胞、KKU-100 および KKU-213B、の細胞生存率をドーズ依存的に大幅に低下させ(最大 30 μg/mL まで)、最高濃度では約 30% の低下が観察されました。また、ALAは、細胞生存率には影響を与えない1 ~ 2 μg/mL の濃度でドーズ依存的に KKU-100 および KKU-213B 細胞の遊走および浸潤能力を大幅に低下させました。

これらの結果は、CCA治療に対するこのレクチンの潜在的な治療効果を示唆しているようです。

海の動植物から発見されたレクチンの糖鎖結合特異性

School of Medicine and Life Sciences, Far Eastern Federal University, Vladivostok, Russiaらのグループは、海の動植物から発見されたレクチンとその脳腫瘍の診断や治療への応用について報告しています。
https://pmc.ncbi.nlm.nih.gov/articles/PMC11679326/

HOL-18:marine sponge Halichondria okadai由来レクチン、複合型N-型糖鎖に結合
OXYL:marine star Anneissia japonica由来レクチン、LacNAc type 2には結合するが、LacNAc type 1には結合しない
AVL:marine sponge Aphrocallistes vastus由来レクチン、シアリルムチンに結合
ESA:seaweed Eucheuma serra由来レクチン、high mannose N-型糖鎖に結合
UPL1:seaweed Ulva pertusa由来レクチン、GlcNAcとhigh-mannose N-型糖鎖に結合
BPL2:seaweed Bryopsis plumosa由来レクチン、trimannosyl coreに結合
KSL:red alga Kappaphycus striatus由来レクチン、high mannose N-型糖鎖に結合
DIFBL:sea bass Dicentrarchus labrax由来レクチン、fucoseに結合
APL:starfish Asterina pectinifera由来レクチン、Tn antigenに結合
CGL:bivalve Crenomytilus grayanus由来レクチン、GalNAc/GalおよびGb3に結合
MytiLec:Mediterranean mussel由来レクチン、Gb3に結合
HCL:marine sponge Haliclona cratera由来レクチン、GalNAc/Galに結合
DTL:ascidian Didemnum ternatanum由来レクチン、GlcNAcに結合

Powered by WordPress |Copyright © 2020 Emukk. All rights reserved